Tuy nhiên, cho đến nay khái niệm này vẫn chưa có định nghĩa thống nhất và chưa được nghiên cứu một cách chuyên sâu, toàn diện trong cả lý luận và thực tiễn quốc tế. Ở trong nước, qua khảo sát sơ bộ, gần như chưa có công trình nào nghiên cứu chuyên sâu, tổng thể về hiện tượng “Rác AI”, thậm chí đây là một thuật ngữ cũng còn khá mới mẻ trên cả các phương tiện truyền thông, báo chí và trong các diễn đàn khoa học - công nghệ.
Bởi vậy, đây là một lĩnh vực còn “trống” về khung lý thuyết nền tảng, chưa được chuẩn hóa trong khoa học dữ liệu, trong khi mức độ ảnh hưởng của nó đến các lĩnh vực kinh tế, chính trị, văn hóa, xã hội, quốc phòng, an ninh, đối ngoại và quản trị quốc gia đang ngày càng hiện hữu, có xu hướng phức tạp, sâu rộng và khó kiểm soát.
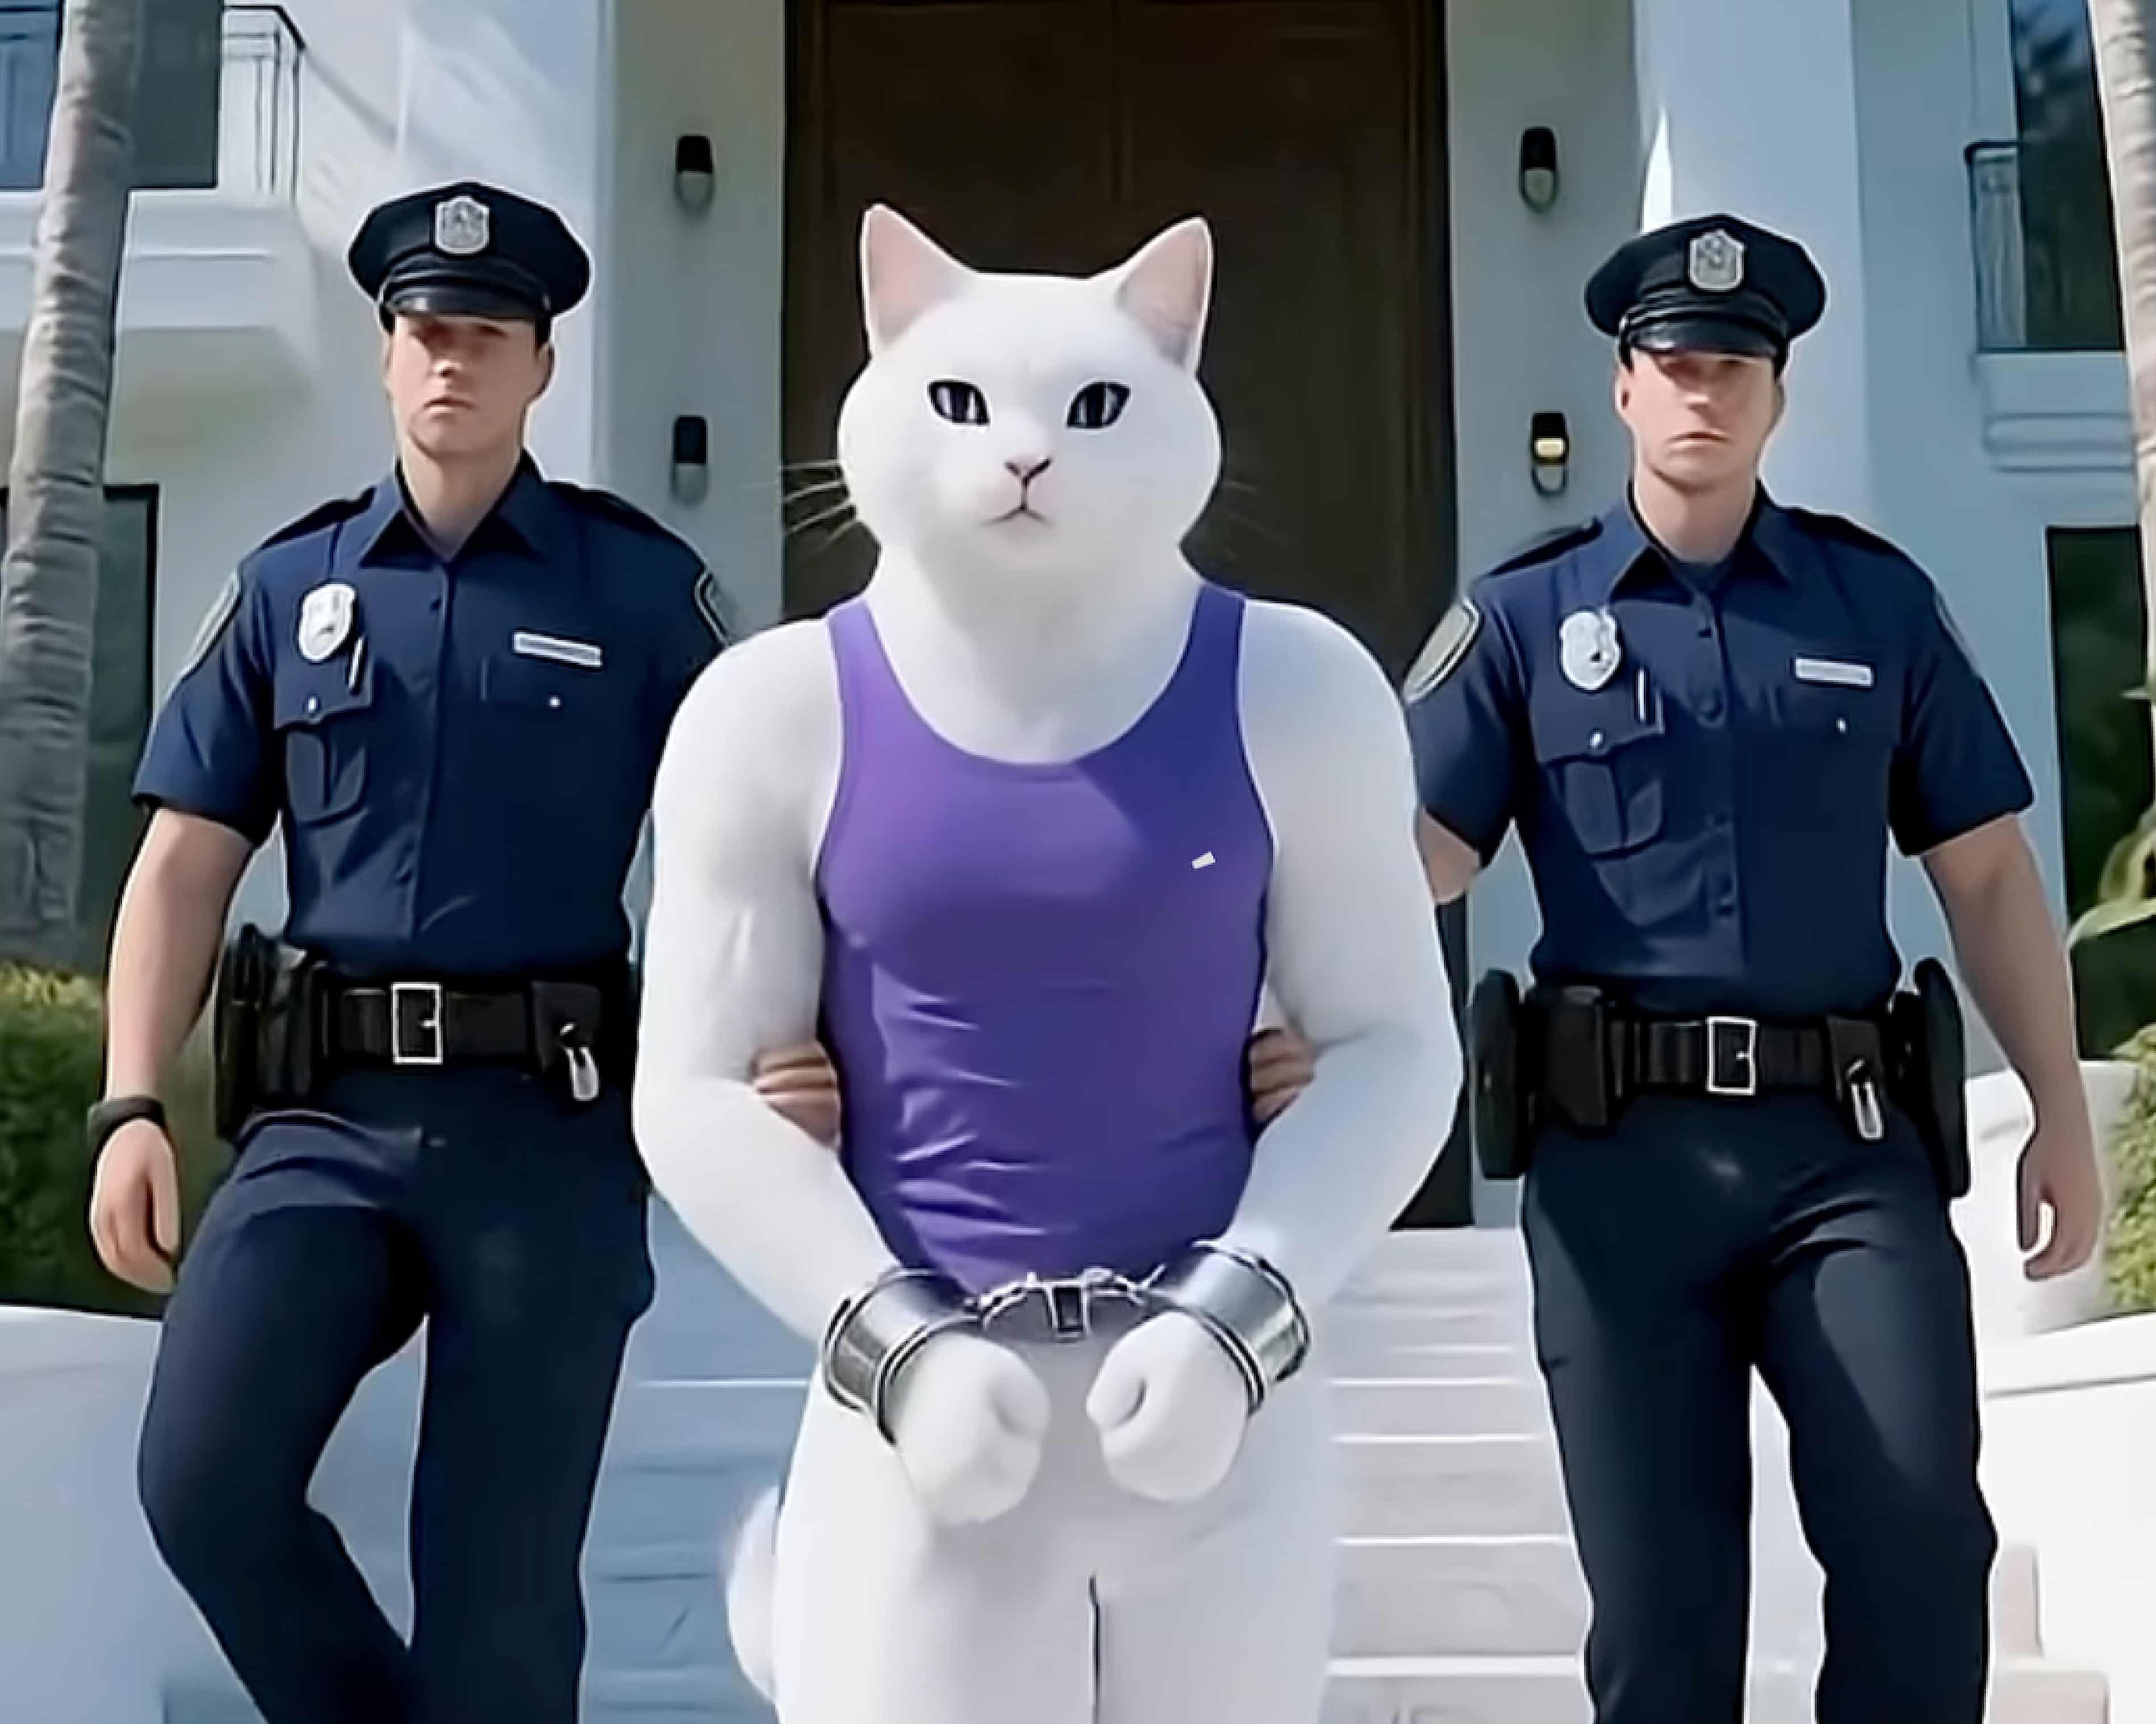 |
| Hình ảnh những chú mèo giống người trong những cảnh ngày càng kỳ quái (do AI tạo ra). Ảnh minh họa: YouTube. |
Hiện nay đã xuất hiện một số cách hiểu bước đầu về “rác AI”, theo đó thuật ngữ này được dùng để chỉ toàn bộ các dạng dữ liệu, thông tin, sản phẩm hoặc kết quả do AI tạo ra hoặc sử dụng nhưng không bảo đảm tính chính xác, tính khách quan, độ tin cậy hoặc tính xác thực.
“Rác AI” bao gồm những dữ liệu đầu vào sai lệch mà AI được huấn luyện, những sai số phát sinh trong quá trình mô hình vận hành và những nội dung đầu ra bị bóp méo do lỗi thuật toán hoặc do chủ ý thao túng của con người. Tuy nhiên, những cách hiểu này mới chỉ là bước đầu, chưa bao quát hết phạm vi phức tạp của hiện tượng, bởi “rác AI” không chỉ đơn thuần là dữ liệu sai, mà còn là các cấu trúc thông tin được tạo sinh có khả năng gây nhiễu loạn nhận thức xã hội, làm suy giảm chất lượng ra quyết định và tạo ra hệ quả mang tính hệ thống.
Thực tiễn cho thấy, nghiên cứu về “rác AI” vẫn còn là một lĩnh vực rất mới bởi các lý do chủ yếu sau đây: (i) Tốc độ phát triển của AI tạo sinh vượt xa tốc độ xây dựng và phát triển lý luận. Các mô hình hiện đại như Chat GPT, diffusion models, video generation (Công nghệ tạo video) hay mô phỏng giọng nói tạo ra khối lượng nội dung khổng lồ, khiến việc phân loại, đánh giá, chuẩn hóa hay kiểm chứng “Rác AI” trở nên khó khăn. (ii) “Rác AI” không chỉ xuất hiện trong kỹ thuật, mà còn lan rộng vào các lĩnh vực như kinh tế, chính trị, văn hóa, truyền thông, pháp luật và an ninh quốc gia, đòi hỏi cách tiếp cận liên ngành mà hiện chưa có hệ thống nghiên cứu nào đủ toàn diện để bao quát đầy đủ các khía cạnh đó. (iii) “Rác AI” mang tính “ẩn” và có khả năng “liên tục tái tạo”, khác biệt đáng kể với rác thông tin truyền thống vốn có hình thái rõ ràng, dễ nhận diện hơn. Một thông tin sai từ AI có thể tiếp tục được các mô hình khác học lại và tái sinh dưới hình thức mới, khiến việc truy vết và kiểm soát trở nên khó khăn hơn nhiều.
Chính vì chưa có định nghĩa thống nhất nên khái niệm “rác AI” trong giới học thuật và quản trị đang được sử dụng theo nhiều ý nghĩa khác nhau. Một số cách tiếp cận xem “rác AI” là dữ liệu nhiễu và dữ liệu gắn nhãn sai trong quá trình huấn luyện mô hình. Một hướng tiếp cận khác nhấn mạnh đầu ra sai lệch và hiện tượng “ảo giác AI”.
Một số nghiên cứu mở rộng hơn, coi “rác AI” là tập hợp toàn bộ các hình thức sai lệch mang tính hệ thống trong môi trường dữ liệu số được tạo ra hoặc khuếch đại bởi AI. Bên cạnh đó, một số học giả lại nhấn mạnh yếu tố lạm dụng AI để tạo sản phẩm giả mạo mang tính tấn công như deepfake, báo cáo giả, nội dung xuyên tạc, coi đây là thành tố quan trọng của “rác AI” trong bối cảnh chiến tranh thông tin hiện đại.
Mỗi cách tiếp cận đều có cơ sở riêng, phản ánh thực trạng chưa hoàn thiện của nền tảng lý luận và sự cần thiết phải xây dựng khái niệm một cách chuẩn mực hơn.
Với mức độ tác động ngày càng lớn của AI đến mọi mặt của đời sống, “rác AI” đang nổi lên như một dạng ô nhiễm thông tin thế hệ mới nhưng chưa có hệ thống học thuật tương xứng để lý giải và quản lý. Tính chất đa tầng, khó nhận diện, tốc độ lan truyền nhanh và khả năng tác động sâu đến các hệ thống hạ tầng dữ liệu quốc gia cho thấy việc hình thành khái niệm khoa học về “rác AI” có ý nghĩa quan trọng không chỉ đối với nghiên cứu lý luận mà còn đối với hoạch định chính sách, thiết kế khung pháp lý, bảo đảm an ninh quốc gia và bảo vệ tính toàn vẹn của không gian mạng.
Do vậy, khái niệm “rác AI” cần tiếp tục được nghiên cứu sâu hơn theo hướng hệ thống hóa các dạng thức tồn tại, cơ chế hình thành, chu trình phát tán, các tác động đa chiều và quan hệ của nó với các lĩnh vực như dữ liệu, mô hình AI, quản trị thông tin và an ninh số. Đây là tiền đề để từng bước xây dựng một định nghĩa có tính bao quát, tính ổn định và khả năng ứng dụng trong khoa học cũng như thực tiễn quản trị quốc gia.
“Rác AI” với bản chất là một hiện tượng mới, phức tạp, chưa được chuẩn hóa và mang nhiều rủi ro tiềm ẩn, đòi hỏi hệ thống nghiên cứu chiến lược phải tiếp cận sớm, chủ động và toàn diện nhằm dự báo các nguy cơ, chủ động xây dựng năng lực phòng thủ và bảo đảm sử dụng AI một cách an toàn, tin cậy và phục vụ phát triển bền vững đất nước.
Với cách tiếp cận trên, bước đầu có thể hiểu “rác AI” là thuật ngữ dùng để chỉ toàn bộ các dạng dữ liệu, thông tin, sản phẩm số hoặc kết quả do hệ thống AI tạo ra hay sử dụng nhưng mang tính sai lệch, nhiễu loạn, thiếu xác thực, không đầy đủ hoặc bị thao túng, từ đó dẫn đến làm suy giảm chất lượng nhận thức, phân tích và ra quyết định của con người và các thiết chế xã hội. Đây là một cách hiểu mở, phản ánh sự xuất hiện ngày càng gia tăng của những sản phẩm số không bảo đảm tính tin cậy trong một môi trường mà AI đang trở thành công cụ sản xuất, lan truyền và tái tạo thông tin chủ đạo.
“Rác AI” bao gồm cả dữ liệu đầu vào kém chất lượng mà AI được huấn luyện, và những dữ liệu đầu ra sai lệch mà AI tạo ra trong quá trình vận hành, cũng như các hình thức thông tin bị chủ ý thao túng để phục vụ mục đích xấu như deepfake, báo cáo giả mạo, nội dung xuyên tạc hoặc mô phỏng có chủ đích nhằm gây nhầm lẫn, phá hoại nhận thức và làm lệch lạc hành vi xã hội.