|
|
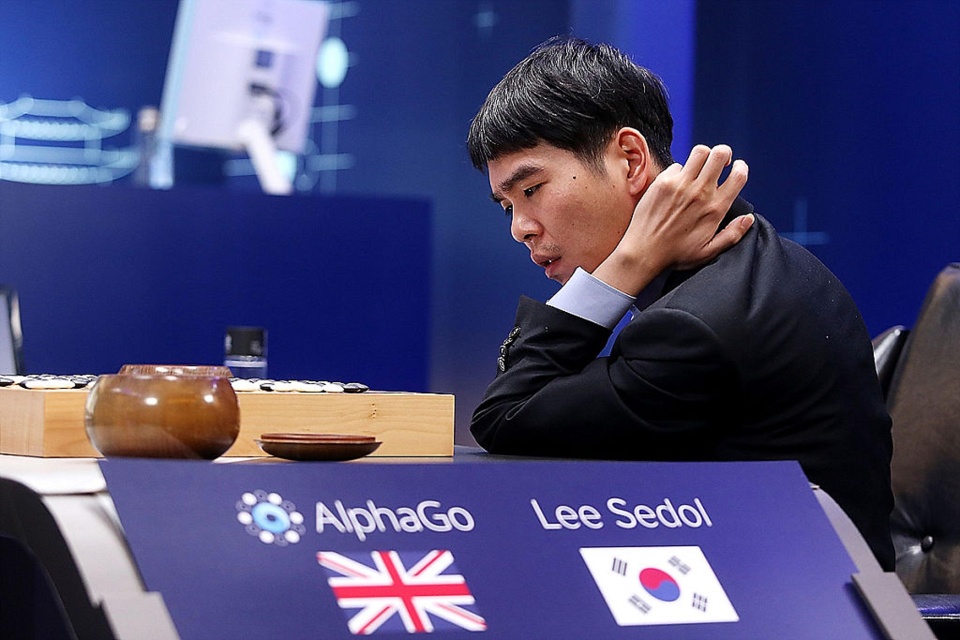
AlphaGo đã đánh bại kỳ thủ đứng thứ hai thế giới lúc bấy giờ là Lee Sedol trong 4/5 ván đấu vào năm 2016. Ảnh: TIME |
Cờ vây có số lượng các nước đi khả dĩ nhiều hơn hẳn cờ vua, và việc đánh giá sự hay-dở của một nước đi cũng khó hơn rất nhiều. Những phương pháp AI từng giúp đánh bại các đại kiện tướng cờ vua gần như không đem lại tiến triển gì khi áp dụng vào cờ vây.
Ngay cả những chuyên gia lạc quan cũng cho rằng bài toán này chưa thể được giải cho đến sớm nhất là thập niên 2020. (Ví dụ, đến năm 2012, nhà tương lai học hàng đầu về AI Nick Bostrom vẫn dự đoán rằng phải đến khoảng năm 2022 AI mới có thể thành thạo cờ vây.)
Vậy mà vào năm 2015-2016, công ty DeepMind, một công ty con của Alphabet đã phát triển AlphaGo sử dụng phương pháp “học sâu tăng cường”, trong đó, một mạng neuron lớn tự xử lý những ván đấu của chính mình và học hỏi từ các ván thắng, thua. Ban đầu, nó được huấn luyện bằng kho dữ liệu khổng lồ về các nước đi của con người, rồi sau đó tự chơi với chính mình vô số ván cho đến khi phiên bản AlphaGo Master đánh bại nhà vô địch cờ vây thế giới Kha Khiết.
Một bước tiến còn ngoạn mục hơn xảy ra chỉ vài tháng sau với AlphaGo Zero. Khi IBM đánh bại đại kiện tướng Garry Kasparov năm 1997 bằng hệ thống Deep Blue, siêu máy tính này đã được “nhồi” toàn bộ các bí kíp mà các lập trình viên của nó có thể thu thập được từ các kiện tướng. Nó là một cỗ máy chỉ chơi được cờ vua và không hỗ trợ được việc gì khác.
Ngược lại, AlphaGo Zero không được cung cấp bất kỳ dữ liệu nào từ con người, ngoại trừ luật chơi. Chỉ sau khoảng ba ngày tự chơi với chính mình, từ những nước đi ngẫu nhiên ban đầu, nó đã vượt qua phiên bản AlphaGo cũ được huấn luyện bằng dữ liệu từ con người với tỉ số 100-0. (Trước đó, AlphaGo đã đánh bại kỳ thủ đứng thứ hai thế giới lúc bấy giờ là Lee Sedol trong 4/5 ván đấu vào năm 2016.)
AlphaGo Zero sử dụng một hình thức học tăng cường hoàn toàn mới, trong đó nó trở thành người thầy của chính mình. Chỉ sau 21 ngày, AlphaGo Zero đạt đến trình độ của AlphaGo Master - phiên bản từng đánh thắng 60 kỳ thủ hàng đầu thế giới qua mạng và hạ gục Kha Khiết với tỉ số 3 : 0 vào năm 2017. Sau 40 ngày, nó vượt qua tất cả phiên bản AlphaGo trước đó và trở thành kỳ thủ cờ vây mạnh nhất từng tồn tại, dù là người hay máy. AlphaGo Zero đạt được điều này mà không có chút kiến thức nào từ con người và cũng không có sự can thiệp của con người.
Nhưng đó vẫn chưa phải cột mốc quan trọng nhất của DeepMind. Phiên bản kế tiếp – AlphaZero – đã làm được điều kỳ diệu hơn: chuyển giao khả năng học được từ cờ vây sang các trò chơi khác như cờ vua. Chương trình này không chỉ đánh bại tất cả kỳ thủ cờ vua là con người, mà còn vượt mặt mọi cỗ máy chơi cờ hiện có chỉ sau bốn giờ tự huấn luyện, với kiến thức đầu vào duy nhất là luật chơi. AlphaZero cũng có thể thể hiện sức mạnh tương tự với trò chơi Shōgi của Nhật Bản.
Phiên bản mới nhất vào thời điểm tôi viết những dòng này là MuZero đã lặp lại tất cả những kỳ tích đó mà không được cung cấp cả luật chơi! Nhờ những năng lực “học chuyển giao” (transfer learning), MuZero có thể thành thạo bất kỳ trò chơi cờ bàn nào không có yếu tố may rủi, mơ hồ hay thông tin ẩn, cũng như các trò chơi điện tử có tính tất định (deterministic) như Pong của Atari. Chính khả năng áp dụng kiến thức từ một lĩnh vực sang lĩnh vực khác có liên quan này là chìa khóa làm nên trí tuệ của con người.